배경
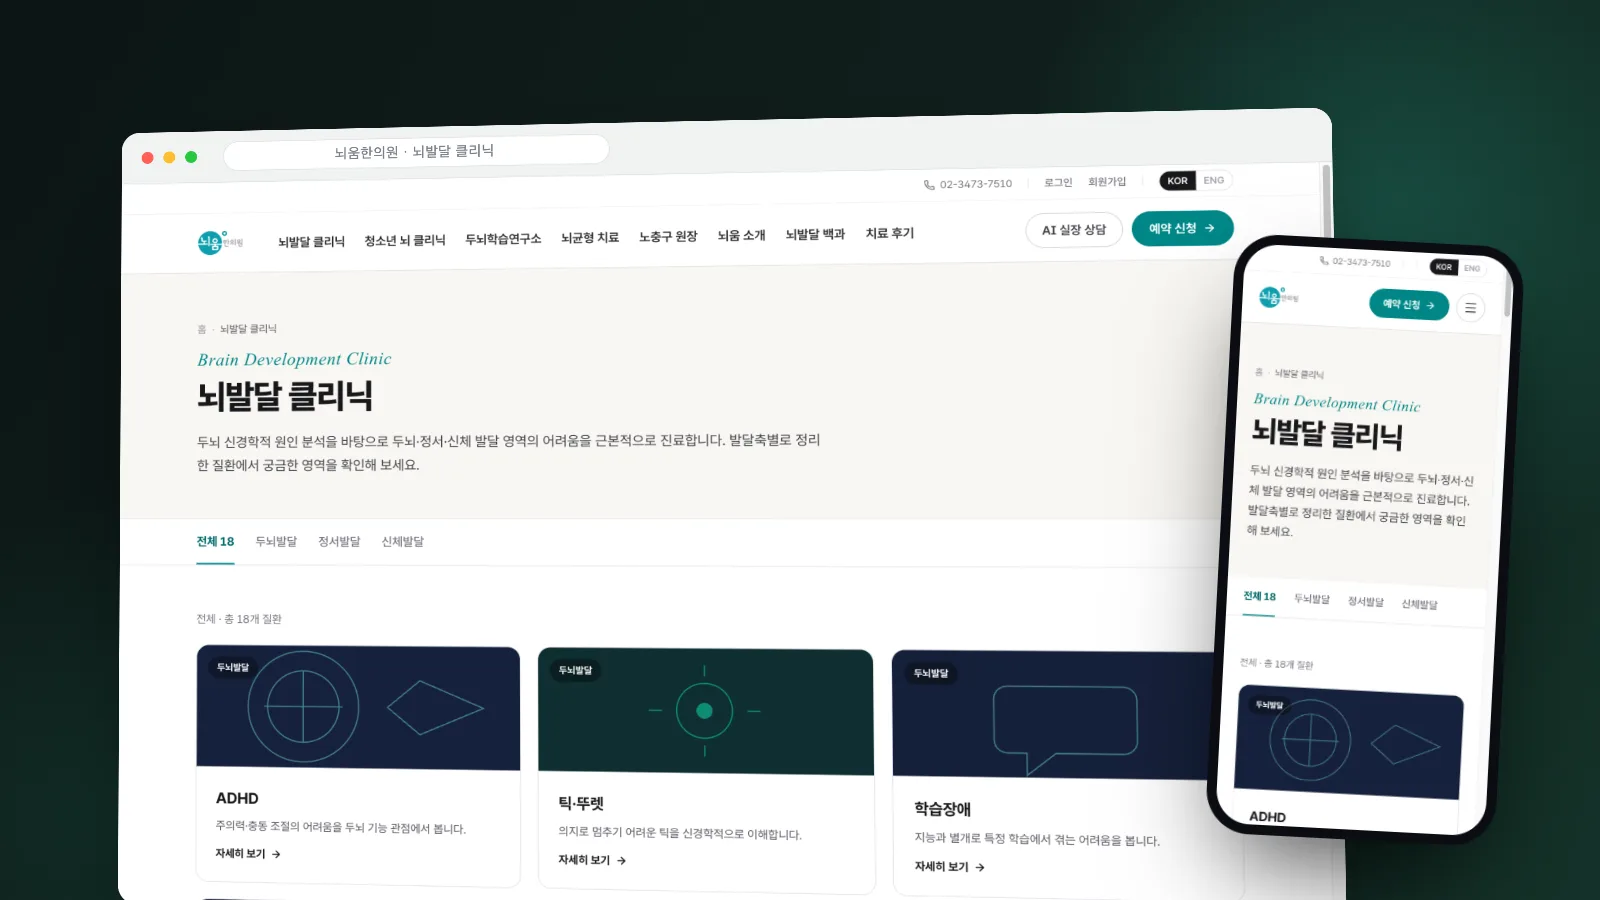
10년 가까이 멈춰 있던 소아·청소년 진료 특화 한의원의 홈페이지와 자체 CMS를 새로 지은 프로젝트입니다. 완성품을 납품하고 빠지는 외주 대신 의료 파트너와 함께 서비스를 세우는 공동사업입니다. PM 겸 개발자로 기획·프론트엔드·배포 체계를 맡았고 리포는 2인이 기여했습니다. 운영 백엔드(CMS·인증·리드)와 AI 챗봇 서버는 각각 백엔드 담당자가 구현했습니다.
규모는 200파일 37.0k LOC이고 원장님 미팅에서 요구사항을 수집해 13개 기능 영역의 기능정의서와 일정(내부 4주·외부 2개월)을 세웠습니다.
정보구조와 시스템 간 계약 명세
- 페이지 표준을 먼저 세움: 진료과목 18개를 상위 메뉴 5개로 묶고 의료진·시술처럼 화면이 감당할 수 있는 최대 수치를 미리 정해 항목이 늘어도 레이아웃이 버티게 했습니다. 의료진 소개·전후 비교·가격표·FAQ처럼 반복되는 형태는 표준 레이아웃으로 묶어 콘텐츠만 채우면 같은 품질의 페이지가 나오게 정리했습니다.
- 세 시스템이 주고받을 계약을 기능정의서 13종으로 직접 명세: WebSocket 접속·메시지 규격과 종료 코드별 프론트엔드 처리, 방문자·회원·운영자·최고관리자 4단계 권한, 대화 로그 30일 보관 뒤 파기, 동의 없는 상담은 서버에서 막도록 검증 위치까지 표로 정리했습니다. 백엔드 팀이 이 문서를 기준으로 구현했습니다. 협의를 왕복하는 대신 명세를 먼저 써서 넘기는 방식이 속도를 만들었습니다.
- 검증된 계보를 가져오고 답변 규칙까지 명세: 챗봇의 WebSocket과 화면 구성 방식은 전시 부스 앱에서 3일간 현장 검증을 마친 구조를 기준 리포로 확정해 같은 방식으로 붙였습니다. 서버는 포크하지 않고 멀티테넌트로 분리 운영하는 쪽으로 정리했습니다. 의료 답변은 골든셋 54문항으로 만들고 진단이 아니라는 고지와 진료 권유 필수 포함 규칙, "완치·보장" 같은 단정 표현을 쓰지 않는 규칙을 함께 정의해 백엔드에 넘겼습니다.
- 막힌 결정을 풀어 일정을 움직임: 대화 로그 보관 기간과 위젯 디자인처럼 "병원 확정 필요"로 걸려 있던 항목은 근거를 정리해 직접 확정했고 출시를 막고 있던 의존성 14건을 통화 한 번으로 전부 확정했습니다. 법적 판단이 필요한 동의 문구 한 건만 자문 회신을 기다렸습니다.
원고 적재 파이프라인: 4단계 검증과 왕복 자검
진료 콘텐츠 33페이지, 블록 6,200여 개를 원고 문서에서 CMS로 옮겨야 했고 수작업으로는 누락과 변형을 걸러낼 방법이 없었습니다. docx 원고 → FE JSON → CMS DB로 이어지는 bundle → validate → load → verify 4단계 파이프라인(16파일 2.8k줄)을 만들어 사람이 전수 검사하지 않아도 원본과 일치함이 보장되게 했습니다.
- 블록 타입 정본을 TS union 18종으로 두고 컴파일타임 패리티 단언과 백엔드 화이트리스트 정합 단언을 이중으로 걸어 타입 정의와 실데이터가 어긋나면 빌드나 적재가 그 자리에서 멈춥니다.
--selftest가 섹션 416개와 블록 6,263개를 적재 뒤 다시 읽어 원본과 대조하는 왕복 검사를 수행합니다.- 실행은 dry-run이 기본이고 dev 호스트 밖에서는 실행을 거부합니다.
build once, deploy many 승격형 배포
dev에서 검증한 빌드와 운영에 올라가는 빌드가 다르면 검증이 무효가 되고 고객사 프로덕션이라 배포 실패가 곧 서비스 중단입니다. main push마다 이미지를 한 번만 빌드(sha 불변 태그)해 dev에 자동 배포하고 운영은 재빌드 없이 검증된 sha에 버전 태그를 붙여 승인 게이트를 거쳐 승격합니다.
배포 스크립트는 헬스체크를 60초 폴링해 실패하면 직전 태그로 자동 롤백하고 운영 서버는 직전 이미지를 보존해 저장소 접근 없이도 되돌릴 수 있습니다. 이미지가 환경을 모르도록 런타임에 env를 주입(/env.js)해 재빌드 없이 환경별 주소를 교체합니다.
시맨틱 구조와 JSON-LD: 검색·AI 인용을 위한 내재화
회원가입·이메일 인증, 카카오 로그인과 지도, 방문 계측, 운영 화면을 직접 구현했습니다. 구조화 데이터는 순수 빌더 패키지 11종(MedicalClinic·Physician·FAQPage·VideoObject 등)으로 분리하고 병원과 원장에 고정 @id를 부여해 검색엔진이 엔티티를 하나로 인식하게 했습니다. 30개 페이지의 canonical과 og:url이 루트 상속으로 전부 홈을 가리키던 것도 실측해 페이지 단위 메타로 정정했습니다.
배포 직후 이미지 전송량을 직접 재보고 당일 고쳤습니다. 질환 상세 한 페이지를 여는 데 이미지가 33.8MB나 내려가고 있었고 원고 이미지를 그대로 쓰던 것이 원인이라 배치 시점에 WebP로 변환하고 next/image로 전환해 약 0.38MB로 줄였습니다.
색인 승계와 자동화: 서치콘솔 기반 301, CMS 발행이 곧 사이트맵
검색 유입이 상담의 주요 진입 경로인 병원 사이트를 URL 구조부터 바꾸고 도메인까지 옮겨야 했습니다. 구 사이트는 색인에서 빠진 URL이 3,000여 건에 이를 만큼 정리가 덜 된 상태라 무엇을 승계할지부터 판단이 필요했습니다.
- 승계 대상은 서치콘솔 실적으로 결정: 16개월 실적(페이지 969행·검색어 999행·외부링크 497행) CSV를 직접 수령해 구 정보구조 클러스터(상담글 329·index.php 186 등)를 실측하고 구 DB 백업 49모듈과 라이브를 전수 대조해 301 매핑표를 만들었습니다. 매핑은 정본 파일 하나를 next.config(경로형)와 middleware(쿼리형·숫자 단축형)가 함께 소비합니다. 구 상담글 449건은 같은 경로와 글 번호로 서빙해 색인된 주소를 승계했고 도메인 전환(www 캐노니컬·HSTS) 뒤 구 주소 5형태 전량 301을 라이브에서 확인했습니다. 저작권이 걸린 언론 기사나 회수할 수 없는 첨부 이미지는 옮기지 않기로 판정했습니다.
- 발행 이후의 색인 신호를 자동화: CMS 발행분(contentReady)이 허브 카드·상세 라우트·헤더 드롭다운·sitemap 네 지점에 같은 목록으로 배선되고 sitemap은 요청 시점 생성과 60초 캐시라 발행 1분 뒤 반영되며 색인 노출 판정은 어드민 체크박스 하나입니다. 의원 문의("백과 발행 속도를 색인이 못 따라온다")를 실측해 사이트맵에 콘텐츠 상세가 0건이고 lastmod가 전부 요청 시각이던 원인을 찾았습니다. 상세 166건을 등재해 40건에서 206건으로 늘리고 lastmod를 실제 발행일로 바꿨으며 모르는 날짜는 비우고 백엔드 목록 limit 100 상한은 페이지 순회로 넘었습니다.
- 공개 상담 게시판 연동: 닥톡 API로 연동해 답변이 네이버 지식iN에 게시됩니다(백엔드 DB·API는 백엔드 구현). 실환경에서 등록 → 게시 → 수정 → 삭제 한 사이클을 완주해 실게시를 확인했습니다.
결과
- 진료 콘텐츠 33페이지 자동 생성: 원고 데이터에서 생성돼 고객사 프로덕션에 라이브
- 섹션 416 · 블록 6,263: 적재 뒤 왕복 자검으로 원본과 대조
- 이미지 1회 빌드 · sha 불변 태그 · 헬스체크 60초 폴링: 실패 시 직전 태그 자동 롤백
- 개발·운영 이중 환경 라이브: 운영 반영은 승인 게이트를 거친 승격만 허용
- 200파일 · 37.0k LOC · 기능정의서 13종: 2인 리포, PM 겸 개발
- 33.8MB → 약 0.38MB: 질환 상세 이미지 전송량 (약 99% 감소)
- 구 주소 131건 301 · 구 상담글 449건 주소 승계: 도메인 전환 뒤 5형태 전량 라이브 확인
- 사이트맵 40건 → 206건: 콘텐츠 상세 등재, lastmod 실제 발행일, 발행 1분 내 반영
- JSON-LD 빌더 11종 · 고정 @id: 병원·원장 엔티티 수렴
- 외부 GEO 측정 리포트(4엔진 동일 기준) 57 → 61: Gemini 인용률 57%에서 80%. 측정 주체는 GEO 담당입니다
- 구글 검색 일 노출 3배 이상: 도메인 전환 한 달 뒤 서치콘솔 기준(2026-10-14 조회). 정확한 전후 합계와 다른 변수 분리는 하지 않았습니다
- 18개 → 5개: 진료과목을 상위 메뉴로 재편
- 54문항: AI 답변 골든셋으로 응답 규칙 명세
- 14건 전건 확정: 출시를 막던 외부 의존성
정리
결정을 문서로 잡아 두고 화면으로 확인받는 방식이 비개발자 파트너와의 협업에서 잘 맞았습니다. 적재와 배포는 사람이 눈으로 확인하는 대신 파이프라인이 어긋남을 실패로 만들게 했고 검증한 것과 배포되는 것이 같은 바이너리라는 원칙을 지켰습니다. 배포 뒤에는 직접 재봐야 문제가 보였습니다. 검색 승계와 색인도 추측 대신 서치콘솔 데이터와 실측으로 결정했습니다.